لماذا لا يصلح أسلوب «اسأل الذكاء الاصطناعي وكفى» للبحث
- الأخطاء تتراكم. إذا كانت كل خطوة صحيحة بنسبة 90%، فإن خمس خطوات متتالية لا تصح كلها إلا في 59% من الحالات.
- ما يبدو مقنعًا ليس بالضرورة موثَّقًا. يكتب النموذج اللغوي بنبرة واثقة. ومن دون قاعدة صارمة تختلط الحقائق بادعاءات الشركات وبالتخمينات.
- لا شيء قابل للتكرار. لا يمكن إعادة توليد إجابة المحادثة في الربع القادم بالبنية نفسها ومعيار الجودة نفسه.
التصميم
وزّعت العمل حسب ما يُجيده كل طرف. يقرّر الذكاء الاصطناعي ويكتب: أيّ المنافسين يستحق الاهتمام، وماذا تعني المعطيات. وينفّذ الكود: جلب المواقع، والتحقق من الاستشهادات، ودمج البيانات، ورسم المخططات البيانية، وتنسيق ملف PDF. ويعتمد شخصٌ النتيجة عند أربع نقاط مراجعة ثابتة.
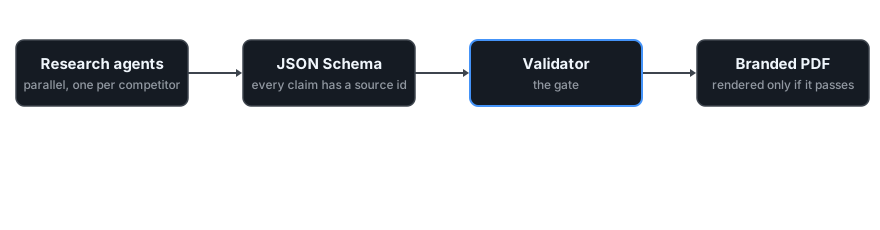
ما يتحقق منه المدقّق
- يطابق كل حقل مخطط JSON Schema، ويحمل كل ادعاء معرّف مصدر واحدًا على الأقل.
- كل معرّف مستشهَد به موجود فعلًا، وله رابط وتاريخ اطّلاع.
- لا نصوص مؤقتة ولا روابط تجريبية (example URLs) في التشغيل الفعلي.
- لا أسماء محظورة.
- لا روابط معطّلة. والصفحات التي تحجب برامج الزحف الآلية (bots) تُعلَّم ليراجعها شخص.
يُبلَّغ الذكاء الاصطناعي بالقواعد، والكود هو الذي يفرضها.
أول تشغيل
تحليل للمنافسين وللسوق لشركة تعمل في سوق رسائل A2P النصية (SMS). عمل تسعة وكلاء بحث في وقت واحد، بوكيل لكل منافس، مع 30 شركة أخرى في جدول ملخّص. وقبل بدء البحث، رُوجع نحو 50 ادعاءً مأخوذًا من ملفات داخلية قديمة وقورن بمصادر روابطها تعمل، فصُحّح 15 منها أو حُذف. وأُنجزت هذه التصحيحات قبل كتابة صفحة جديدة واحدة.
ما كنت سأفعله بطريقة مختلفة
كنت سأعدّ المصادر والادعاءات بأداة واحدة. فقد اختلف العدّ قليلًا بين ملفات البحث والتقرير النهائي (192 مقابل 189 مصدرًا)، ولهذا تُقرّب هذه الصفحة الأرقام.